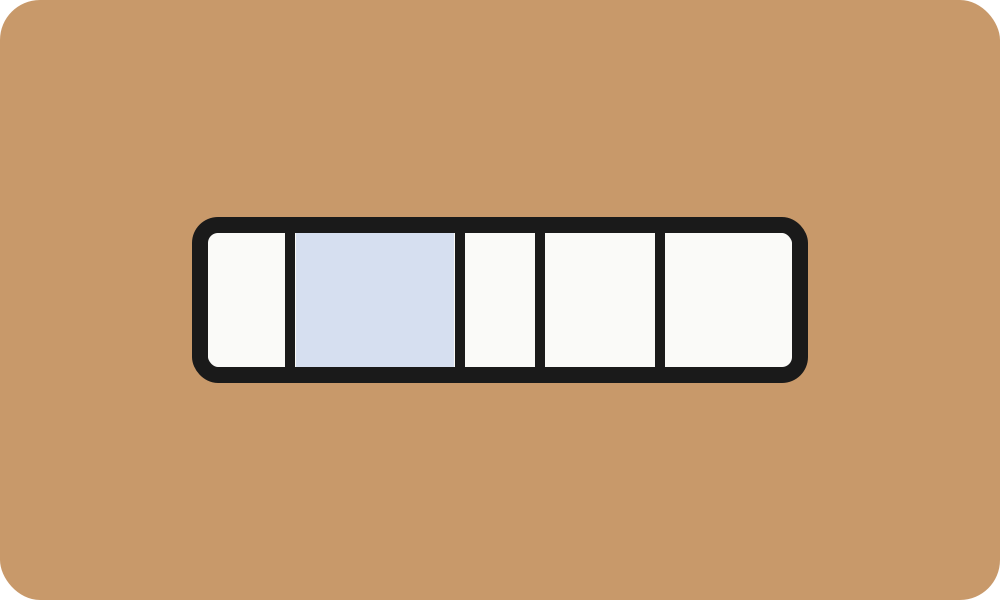
Rečenicu “Šta je token i zašto je važan?” GPT-4 dijeli na 14 tokena (osnovnih jedinica teksta koje model obrađuje: riječi ili dijelova riječi). Prva dva tokena zajedno čine samo slovo „Š“. Ista rečenica na engleskom ima samo 10 tokena. Broj tokena određuje koliko košta korištenje modela i koliko teksta model može obraditi odjednom.
Ukratko
Token je najmanja jedinica teksta s kojom radi veliki jezički model (large language model, LLM): cijela riječ, dio riječi, znak ili bajt. Tokenizacija (tokenization) dijeli tekst na tokene iz vokabulara, fiksnog skupa tokena koje model poznaje. Vokabular se gradi statistički, na primjer algoritmom BPE ili Unigram. Česti nizovi znakova postaju jedan token, a rijetki se dijele na manje dijelove. Zato token nije isto što i riječ. Iz istog razloga bosanski tekst obično ima više tokena nego engleski tekst istog sadržaja: vokabular se uglavnom gradi na engleskim tekstovima, pa su bosanski nizovi znakova u njemu rjeđi. Cijena korištenja modela i veličina kontekstnog prozora (context window) mjere se u tokenima.
Token i tokenizacija
Model ne čita slova ni riječi. Tokenizator mu predaje tekst kao niz tokena. Sve što model radi, radi nad tim nizom.
Token može biti cijela riječ ako je ta riječ česta. U našem testu riječ „token“ ostaje jedan token, zajedno s razmakom koji joj prethodi. Tokenizatori koje smo testirali lijepe razmak uz riječ koja slijedi. Token može biti i dio riječi, pa čak i jedan bajt. Ako vokabular nema riječ kao cjelinu, tokenizator je slaže od podriječi (subword), tj. dijelova riječi koji jesu u vokabularu.
Učestalost odlučuje kako će tekst biti podijeljen. Tokenizator ne zna gramatiku. Zna samo koji su se nizovi znakova često pojavljivali u tekstu na kojem je izgrađen.
Kako token funkcioniše
Dva poznata algoritma rade suprotno: jedan gradi vokabular odozdo, drugi ga reže odozgo.
BPE (byte-pair encoding) počinje od pojedinačnih znakova i posebne oznake za kraj riječi. Zatim stalno ponavlja isti korak: pronađe najčešći par susjednih simbola u tekstu i zamijeni ga novim simbolom. Na primjer, ako se “r” i “a” najčešće pojavljuju jedno uz drugo, spajaju se u “ra”, a brojanje počinje iznova. U radu Sennricha i saradnika veličina vokabulara jednaka je broju početnih znakova uvećanom za broj spajanja. Broj spajanja jedini je parametar koji treba odabrati. Spajanja nikad ne prelaze granicu riječi.
OpenAI je za GPT-2 BPE prebacio na nivo bajtova. Razlog je praktičan: kad bi osnovu činili svi Unicode znakovi, početni skup imao bi više od 130.000 simbola. Bajtova ima samo 256. Spajanja između različitih vrsta znakova, npr. slova i interpunkcije, zabranjena su. Bez toga bi “dog.”, “dog!” i “dog?” postali zasebni tokeni. Vokabular GPT-2 ima 50.257 tokena, a zapisati se može svaki tekst.
Unigram ide obrnuto (Kudo, 2018). Kreće od velikog početnog vokabulara i u krugovima izbacuje podriječi čije uklanjanje najmanje smanjuje vjerovatnoću kojom model opisuje tekst, npr. zadržava najboljih 80%. Pojedinačni znakovi uvijek ostaju. Unigram svakoj podriječi pridružuje vjerovatnoću, pa isti tekst može imati više mogućih podjela, svaku sa svojom vjerovatnoćom. Alat SentencePiece primjenjuje i BPE i Unigram direktno na sirov tekst, a razmak tretira kao običan simbol (▁).
Za neke modele veličina vokabulara je javna. Prema OpenAI-jevoj biblioteci tiktoken, vokabular cl100k_base (GPT-4, GPT-3.5-turbo) ima 100.277 tokena, a o200k_base (GPT-4o, o1, o3, GPT-4.1, GPT-5) 200.019. Meta za Llama 3 koristi 128.000 tokena: 100.000 iz tiktokena i 28.000 dodatnih za jezike osim engleskog. Prema Metinom radu, jedan token engleskog teksta time u prosjeku pokriva 3,94 znaka umjesto 3,17 kod Llama 2. Meta na blogu navodi do 15% manje tokena. To je tvrdnja proizvođača.
Koliko znakova ima jedan token?
Zavisi od modela i jezika. To navodi i Anthropic u svojoj dokumentaciji. Kod ranijih modela Claude jedan token odgovara otprilike 3,5 znaka engleskog teksta. Modeli od Claudea 4.7 nadalje koriste novi tokenizator, koji za isti tekst daje oko 30% više tokena. Obje brojke su okvirne procjene proizvođača. Za tačan broj Anthropic nudi brojanje tokena putem svog API-ja (application programming interface, programski interfejs), za model koji namjeravate koristiti.
Na bosanski tekst ove procjene se ne mogu direktno primijeniti. Gruba pravila tipa „toliko znakova po tokenu“ izvedena su iz engleskog teksta.
Bosanski u tokenima: naš test
Tri rečenice na bosanskom i njihove engleske prijevode propustili smo kroz dva OpenAI-jeva tokenizatora: cl100k_base (GPT-4) i o200k_base (GPT-4o). Tri rečenice nisu statistika. Rezultat ne pokazuje koliko tokena bosanski tekst troši uopšteno.
| Rečenica | cl100k_base | o200k_base |
|---|---|---|
| Šta je token i zašto je važan? | 14 | 11 |
| What is a token and why does it matter? | 10 | 10 |
| Đaci čitaju knjige u čitaonici. | 14 | 13 |
| Students read books in the reading room. | 8 | 8 |
| Ćevapi su najukusniji uz hljeb i luk. | 17 | 16 |
| Ćevapi are tastiest with bread and onion. | 12 | 11 |
U rezultatima se vide tri stvari:
- Neka slova s dijakritikom troše dva tokena. U cl100k_base “Š” i “Ć” postaju po dva tokena, a “Đ”, “č”, “ž” i “š” ostaju po jedan token. U o200k_base i “Š” i “Ć” su po jedan token.
- Podjele ne prate uvijek slogove. “zašto” je u cl100k_base
za|š|to, a u o200k_baseza|što. “Hljeb” jehl|j|eb, a o200k_baseh|lj|eb. “čitaonici” je u oba tokenizatorač|ita|on|ici. - Razlika se uglavnom smanjila, ali nije nestala. U o200k_base bosanske rečenice imaju jedan do tri tokena manje nego u cl100k_base. Engleske se mijenjaju za najviše jedan token. U prve dvije rečenice razlika između bosanskog i engleskog se smanjila, a u trećoj je ostala ista: pet tokena.
Sistematsko mjerenje objavili su Petrov i saradnici 2023. godine. Prema njihovim rezultatima, bosanski tekst u cl100k_base ima u prosjeku 1,87 puta više tokena od engleskog. Detalje i ograničenja te studije opisali smo u tekstu Šta je LLM i kako radi?
Praktične implikacije
- Cijena. Proizvođači naplaćuju korištenje modela preko API-ja po tokenu. Zato isti sadržaj na bosanskom može koštati više nego na engleskom.
- Kontekstni prozor. Veličina prozora mjeri se u tokenima, pa u njega stane manje bosanskog teksta nego engleskog.
- Promjena modela. Različiti tokenizatori za isti tekst daju različit broj tokena. To pokazuju i naš test i novi Anthropicov tokenizator, koji daje oko 30% više tokena. Procjena napravljena za jedan model ne važi automatski za drugi.
- Brojevi. Tokenizator dijeli i brojeve, a način podjele može uticati na to koliko pouzdano model računa. U našem testu
12345678u oba vokabulara postaje123|456|78. Meta je u prvom modelu LLaMA sve brojeve dijelila na pojedinačne cifre.
Šta token nije
Token nije isto što i riječ, slog ili morfem (najmanji dio riječi koji nosi značenje). Podjela je statistička. Prosječan broj tokena po riječi zove se fertilnost (fertility) tokenizatora. Fertilnost zavisi od jezika i od tokenizatora.
Nije dokazano da tokeni uzrokuju greške u brojanju slova. To je često objašnjenje. cl100k_base zaista dijeli riječ „strawberry“ na str|aw|berry. Zato se često kaže da model ne vidi pojedinačna slova. Ali Fu i saradnici (2024) pokazali su da modeli slova prepoznaju, a griješe tek kad ih broje. Učestalost riječi i njenih tokena nije značajno uticala na greške. Greške su jako korelirale s brojem slova i tokena u riječi, a najjače s brojem slova koja se u riječi pojavljuju više puta. Uzrok zato još nije razjašnjen.
Povezano
- Šta je LLM i kako radi? – kako model od niza tokena generiše tekst i koliko bosanski “plaća” više tokena
Izvori
- Neural Machine Translation of Rare Words with Subword Units – Sennrich et al.
- SentencePiece – Kudo i Richardson, 2018
- tiktoken – OpenAI, GitHub
- The Llama 3 Herd of Models – Meta
- Glossary: Tokens – Anthropic, Claude dokumentacija
- Why Do Large Language Models (LLMs) Struggle to Count Letters? – Fu et al., 2024
- Language Model Tokenizers Introduce Unfairness Between Languages – Petrov et al., 2023